InfluxDB 実践ユースケース: IoT・インフラ監視・アプリメトリクス
InfluxDB 実践ユースケース
InfluxDB は時系列データ (time-series data) に特化したデータベースです。「時刻付きの大量データを書き込みつつ、時間範囲でクエリする」というパターンに対して、汎用 RDB や KVS では得られないスループットとストレージ効率を提供します。
本記事では、実際の現場で InfluxDB が選ばれる 3 つの代表的なユースケースを、データモデル・クエリ・運用上の落とし穴まで踏み込んで解説します。
基本情報
| OSS 詳細 | InfluxDB の概要・内部アーキテクチャは InfluxDB の紹介記事 を参照してください。 |
|---|
全体像
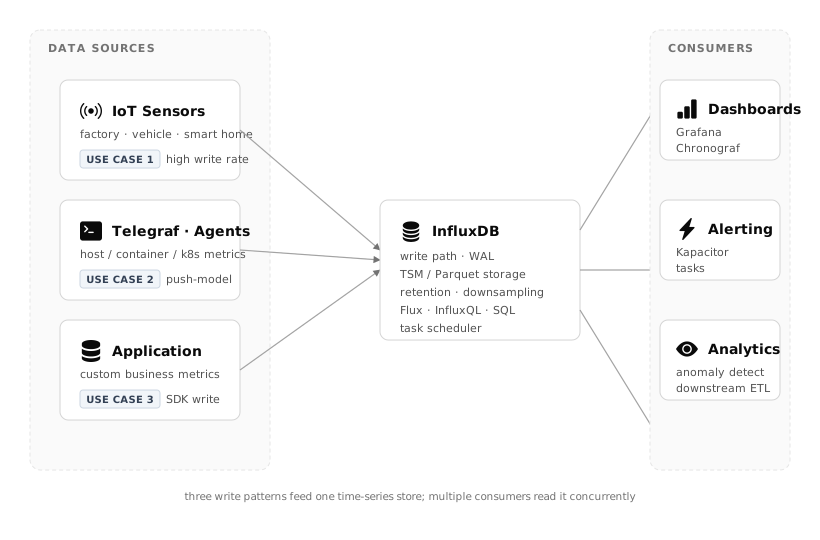
書き込み側は 3 つのパターン (IoT / Agent / Application) に収斂し、読み出し側は Dashboard・Alerting・Analytics に広がります。この「fan-in / fan-out」構造が InfluxDB の典型的な配置です。
なぜ時系列 DB か
汎用 RDB (PostgreSQL など) でも時刻カラムに INDEX を張れば時系列クエリは書けます。ただし次のような要件が重なると急速に辛くなります。
- 書き込みが毎秒数万〜数百万ポイント: B-tree インデックスの更新コストで詰まる
- データ量が年単位で TB 級: 行指向ストレージはディスク効率が悪い
- 保存期間ポリシーを自動管理したい: 「生データは 30 日、集約は 2 年」といった運用
- ダウンサンプリング: 1 秒粒度のデータから 1 分平均・1 時間平均を派生させる
InfluxDB (v3 以降は Parquet + DataFusion、v2 までは TSM) は、これらを時系列特化のストレージ設計で解決しています。
ユースケース 1: IoT センサーデータ基盤
シナリオ
工場の生産ラインに 10,000 個のセンサーが設置されており、1 秒ごとに温度・圧力・振動を記録します。
- 書き込み: 約 30,000 points/sec (10,000 センサ × 3 メトリック)
- 読み出し: 現場ダッシュボード (直近 1 時間) と、品質管理バッチ (過去 7 日の統計)
- 保存要件: 生データ 30 日、1 分集約 1 年、1 時間集約 永久
データモデル
 1measurement: sensor_metric
 2tags:
 3  factory_id    = "osaka-01"
 4  line_id       = "line-A"
 5  sensor_id     = "s-0001"
 6  metric_type   = "temperature" | "pressure" | "vibration"
 7fields:
 8  value         = 23.4           (float)
 9  status        = "ok" | "warn"  (string)
10timestamp:      = 2026-10-11T12:00:00.123Z
tag はインデックス対象、field はインデックス対象外です。「集計やフィルタでよく使うもの」を tag に、「値そのもの」を field に置くのが基本です。
クエリ例 (Flux)
直近 1 時間の、ライン A の 1 分平均温度:
1from(bucket: "sensors")
2  |> range(start: -1h)
3  |> filter(fn: (r) =>
4      r._measurement == "sensor_metric" and
5      r.line_id == "line-A" and
6      r.metric_type == "temperature")
7  |> aggregateWindow(every: 1m, fn: mean)
落とし穴: カーディナリティ
tag の組み合わせ数 (series cardinality) が爆発すると、インデックスがメモリを食い潰します。
- OK:
factory_id (10) × line_id (50) × sensor_id (10,000) × metric_type (3)= 15M series - NG:
user_idやtrace_idのように無限に増える値を tag に入れる
💡 Tip: ユニークな ID や高基数の値は tag ではなく field として扱う。カウントや集計の対象になる場合でも、カーディナリティ制約を先に意識する。
落とし穴: 保存ポリシーとダウンサンプリング
生データを永続保存するとディスクが即座に埋まります。InfluxDB の task (旧 Continuous Query) で定期集約を書くのが定石です。
1option task = { name: "downsample-1m", every: 1m }
2
3from(bucket: "sensors")
4  |> range(start: -task.every)
5  |> aggregateWindow(every: 1m, fn: mean)
6  |> to(bucket: "sensors_1m")
bucket ごとに retention policy を設定し、sensors は 30d、sensors_1m は 365d といった運用で、ディスクとクエリ性能を両立します。
ユースケース 2: Telegraf + InfluxDB + Grafana でインフラ監視
シナリオ
数百台のサーバー / 数千の Kubernetes Pod のメトリクス (CPU・メモリ・ネットワーク・ディスク IO・Pod ステータス) を一元可視化し、閾値超過でアラートを飛ばします。
定番スタック
 1Hosts / Containers / Pods
 2        │ (collect)
 3        ▼
 4     Telegraf      ← 公式エージェント・300+ プラグイン
 5        │ (push)
 6        ▼
 7     InfluxDB      ← 時系列ストレージ
 8        │ (query)
 9        ▼
10     Grafana       ← 可視化・アラート
なぜ Prometheus ではなく InfluxDB か
Kubernetes 時代の監視は Prometheus がデファクトですが、以下のケースでは InfluxDB の方が合います。
| 観点 | Prometheus | InfluxDB |
|---|---|---|
| 収集モデル | pull (scrape) | push (Telegraf から) |
| 長期保存 | リモートストレージ併用が必要 | 単体で年単位の保存可 |
| 多拠点・NAT 越え | pull なので構成が複雑 | push なのでシンプル |
| SQL 互換 | PromQL のみ | InfluxQL / SQL / Flux |
Edge / IoT ゲートウェイが NAT 内にいて pull できない、データを数年単位で残したい といった要件があるときに InfluxDB が有利です。
Telegraf 設定の肝
 1[[inputs.cpu]]
 2  percpu = true
 3  totalcpu = true
 4
 5[[inputs.kubernetes]]
 6  url = "https://$NODE_IP:10250"
 7  bearer_token = "/var/run/secrets/.../token"
 8
 9[[outputs.influxdb_v2]]
10  urls = ["http://influxdb:8086"]
11  token = "$INFLUX_TOKEN"
12  organization = "glv"
13  bucket = "infra"
出力バッファと flush interval を調整しないと、Pod 障害時にメトリクスが欠損するか、逆にリトライで InfluxDB を潰します。本番では以下の設定が目安です。
metric_batch_size = 5000metric_buffer_limit = 50000flush_interval = "10s"flush_jitter = "5s"(突発的な集中を避ける)
ユースケース 3: アプリケーションのビジネスメトリクス
シナリオ
SaaS プロダクトで、以下の「ビジネス指標」を時系列として蓄積し、プロダクトマネージャーのダッシュボードに映す。
- アクティブユーザー数 (1 分粒度)
- 課金イベント数・金額
- API エンドポイントごとのリクエスト数・P95 レイテンシ
- 機能別の利用カウント
既存の APM (New Relic・Datadog) で見えるものと重なりますが、SaaS 料金が青天井 になるのを避け、ドメイン固有の指標 を自前で握りたいケースです。
データモデル
1measurement: business_event
2tags:
3  env           = "prod"
4  service       = "billing"
5  event_type    = "subscription_created"
6  plan          = "pro" | "team" | "enterprise"
7fields:
8  count         = 1
9  amount        = 29.00
tag に user_id を入れたくなりますが、カーディナリティ爆発するので field に落とします。「ユーザー別分析」は、別途 DWH (BigQuery / Snowflake) に送るのが現実的です。
書き込みパターン
アプリから直接 InfluxDB クライアントで write する、または Telegraf の http / exec input を挟む 2 択です。可用性を取るなら Telegraf を挟む構成が安全です。
 1from influxdb_client import InfluxDBClient, Point
 2
 3client = InfluxDBClient(url="...", token="...", org="glv")
 4write_api = client.write_api()
 5
 6p = (Point("business_event")
 7     .tag("service", "billing")
 8     .tag("event_type", "subscription_created")
 9     .tag("plan", "pro")
10     .field("count", 1)
11     .field("amount", 29.00))
12write_api.write(bucket="business", record=p)
クエリ例
直近 24 時間の plan 別 MRR (概算):
1from(bucket: "business")
2  |> range(start: -24h)
3  |> filter(fn: (r) =>
4      r._measurement == "business_event" and
5      r.event_type == "subscription_created" and
6      r._field == "amount")
7  |> group(columns: ["plan"])
8  |> sum()
まとめ: InfluxDB をいつ選ぶか / 選ばないか
選ぶ
- 書き込みが時間順・高頻度: 秒間数千〜数百万ポイント
- 時間範囲 + タグフィルタ が主なクエリパターン
- 保存期間ポリシー・自動ダウンサンプリング を宣言的に扱いたい
- Telegraf + Grafana の既製スタック を活かしたい
選ばない
- 行単位の UPDATE / DELETE が頻発: 時系列 DB は append-only が前提
- トランザクション: 複数行の原子的更新が要件なら RDB
- ユーザー ID のような高カーディナリティ軸での横断分析: DWH 向き
- 低頻度・低量: RDB の時刻 INDEX で十分なケースで、オーバーエンジニアリングを避ける
InfluxDB は「万能 DB」ではなく、時系列という特定のパターンに最適化された道具 です。採用判断は「書き込みパターン・クエリパターン・保存要件」の 3 軸で決めるのが、現場で後悔しないコツです。